このセミナーは株式会社情報機構の主催です。主催・お申し込み・お支払いは株式会社情報機構です。当社(イーコンプライアンス)では、この講座の申込・決済・見積・ポイント付与は扱いません。
情報機構のページで詳細を見る・申し込む →
日時・受講料
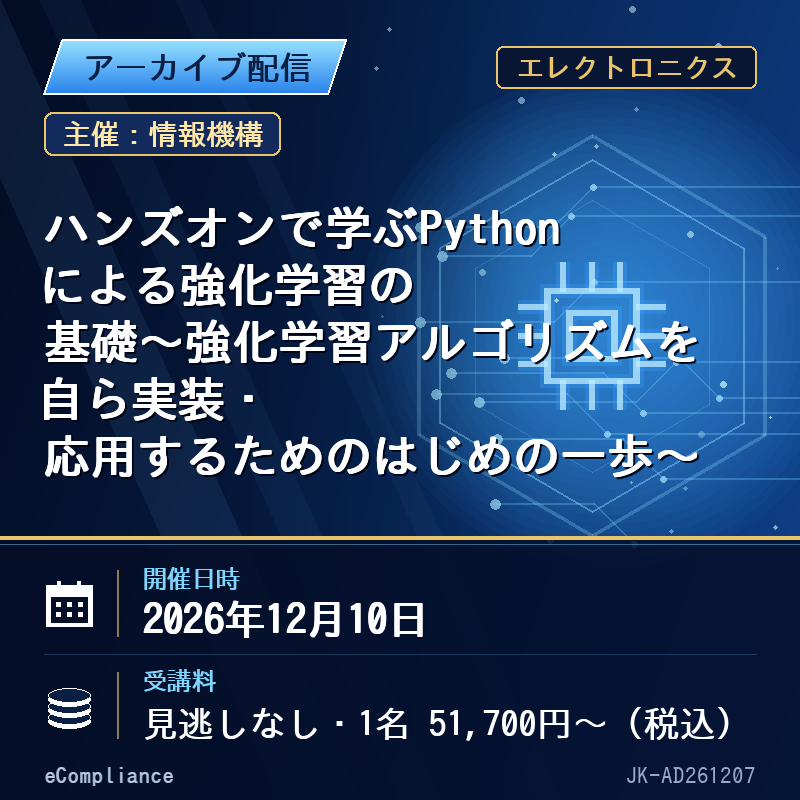
- 日時:2026年12月10日(木) 10:30-16:30
- 【オンライン受講(見逃し視聴なし)】1名 51,700円(税込)/1社2名以上同時申込の場合 1名につき 40,700円
- 【オンライン受講(見逃し視聴あり)】1名 57,200円(税込)/1社2名以上同時申込の場合 1名につき 46,200円
受講料・日程・割引の詳細と最新の情報は、情報機構のページでご確認ください。
愛知県立大学 情報科学部 情報科学科 教授 小林 邦和 氏
セミナーポイント
■はじめに:
本セミナーでは,Pythonによるハンズオンを通じて,古典的な強化学習から最新の深層強化学習まで体系的に学びます.単なる理論の解説ではなく,エージェントがどのように試行錯誤しながら学習するのかについて,実際にコードを書き,可視化しながら理解することを重視します.古典的なQ学習(強化学習)の多腕バンディット問題から最新の深層Qネットワーク(深層強化学習)のCartPoleへの適用および実装までを体験し,強化学習アルゴリズムを自ら実装・応用できる力を身につけます.
■受講対象者:
・Pythonを用いた機械学習・AI技術(特に強化学習)に興味のある技術者の方
・強化学習をこれから学びたい方,または基礎から体系的に理解したい方
・業務へ活かすため,強化学習アルゴリズムの基礎知識や実装方法を習得したい方
・強化学習を学んだことはあるが,なぜ学習できるのかを十分理解できていない方
・ゲームAI,ロボティクス,自律制御などへの応用に興味のある方
・実際にPythonコードを書きながら,強化学習を体験的に学びたい方
・本テーマに興味のある方ならどなたでも受講可能です
■必要な予備知識:
・高校卒業レベルの数学の知識
・Pythonの基礎文法(条件分岐,繰り返し処理,関数など)の知識
・Pythonによる簡単なデータ処理・可視化の基礎知識
・強化学習やニューラルネットワークの予備知識があると理解しやすくなりますが,必須ではありません
■本セミナーで習得できること:
・強化学習の基礎概念(エージェント,環境,報酬,状態,行動)の理解
・Q学習や深層Qネットワークなどの代表的アルゴリズムの基礎知識
・Pythonを用いた強化学習アルゴリズムの実装方法
・Q学習や深層Qネットワークにおける学習過程の可視化と結果の評価方法
・強化学習におけるハイパーパラメータ調整や学習失敗時の対処法
など
セミナー内容
1.強化学習の基礎
1)機械学習の概要
a)教師あり学習・教師なし学習・強化学習の違い
b)エージェント・環境・報酬
2)強化学習の応用例
a)ゲームAI(Atari,マリオAI,AlphaGo)
b)ロボティクス(自律移動,制御最適化)
3)セミナーのゴール
2.多腕バンディット(スロットマシン)問題
1)多腕バンディット問題
2)バンディットの価値推定
3)プレイヤーの行動戦略(探索vs活用)
4)ハンズオン
a)バンディット・エージェント・方策の実装
b)ハイパーパラメータの相違による性能比較
3.マルコフ決定過程(MDP)と動的計画法
1)MDP(エージェントと環境との相互作用)
2)ベルマン方程式
a)状態価値関数
b)行動価値関数
3)動的計画法
a)方策評価
b)方策改善
c)価値反復法
4)ハンズオン
a)グリッドワールド環境の実装
b)価値反復法の実装
4.Q学習
1)モデルベースvsモデルフリー
2)Q学習のアルゴリズムと学習方法
3)ハンズオン
a)グリッドワールド環境におけるQ学習の実装
b)学習過程の可視化
5.深層強化学習(深層Qネットワーク)
1)ニューラルネットワーク導入の理由
2)深層Qネットワーク(DQN)の基本構造
a)ニューラルネットワークによるQ関数の近似
b)経験再生
c)ターゲットネットワーク
3)DQNのアルゴリズムと学習方法
4)ハンズオン
a)DQNの実装
b)CartPole問題における動作確認
6.まとめ
1)最新動向
2)質疑応答
【注意事項】
当日の進行状況に応じて,ハンズオン演習はすべての項目が取り上げられない可能性があります.
出典:株式会社情報機構(https://johokiko.co.jp/seminar_chemical/AD261207.php)。掲載は情報機構との提携によります。
レビュー
レビューはまだありません。